動画で見る:ヒューマノイドロボットとフィジカルAIの現在
後編で扱う「学習したAIが現実世界で動く」姿を、まず映像でご覧ください。画像をクリックするとYouTubeで再生します。
前編では、フィジカルAI※の登場背景と開発の全体像、学習データの種類と集め方、必要な機材とソフトウェアを見てきました。後編は、その先の核心部です。集めた人間の動きはなぜそのまま使えないのか。AIはどうやって動きを覚えるのか。そして、シミュレーションで完璧だったロボットが、なぜ現実の床では転ぶのか。
(※印の用語は、編末の用語集に説明があります)
前編を読む|フィジカルAI開発の全体像と、データ・機材・ソフトウェアの準備
前編のおさらい
- フィジカルAI=現実世界で身体を持って動くAI。間違いが物理的な事故につながるため、データ・シミュレーション・安全の工程が重くなる
- 開発の流れ:学習の材料を用意 → データ加工 → AI学習 → シミュレーションやオフライン評価 → 実機検証 → ログを戻して改善、のループ
- 学習データにはモーションキャプチャ、テレオペレーション、動画、合成データ※、公開データセット、実機ログなどがあり、別の出発点として報酬設計(データの代わりに「何が良い行動か」を定義する)や既存の基盤モデル※を利用する方法もある。実務ではこれらを組み合わせる
- 題材はUnitree G1:開発の全工程を公開情報で追える小型ヒューマノイド。考え方は他機にも共通
- 道具立て:Ubuntu+GPU+安全装置が土台。代表的なソフトウェアの選択肢としてROS 2、Isaac系、MuJoCo、LeRobotなどがある
ここからは、流れの「データ加工」ステップに入ります。
第6章 なぜ人の動きは、そのままロボットに入らないのか ⸺ データ加工とリターゲティング
本章で扱うのは、人間の動作データ(モーションキャプチャ等)を利用する場合の加工工程です。強化学習※のみで進める場合や、テレオペ・実機ログ・基盤モデルを出発点にする場合、本章の変換処理の多くは不要になります(時刻同期※やノイズ処理などの基本的なクリーニングは、どのデータでも必要です)。
6-1. 体が違う、という単純で深刻な問題人
人間の動作データがそのまま使えない理由は、人間とロボットの体が違うからです。
| 違い | 人間 | Unitree G1(例) | 起きる問題 |
|---|---|---|---|
| 体格 | 例:身長170cm | 約130cm | 届いていた棚に手が届かない。歩幅も合わない |
| 関節 | 多数の関節と連続的な可動性(背骨のしなり等) | 構成により23~43個の関節モーター(公式資料:G1は23、G1 EDUは構成により23~43) | 滑らかな動きを限られた関節で「近似」するしかない |
可動域※ | 肩は非常に広い | 各関節に機械的な限界角度 | 姿勢をコピーすると関節限界を超えて破損 |
| 重量・重心 | 約60kg、重心は骨盤付近 | 約35kg、重心位置が異なる | 人間では立てる姿勢でもロボットは転倒 |
| 指の構造 | 5本指×多関節 | 3本指または多指ハンド(オプション) | 「つまむ」を別構造のハンドに翻訳する必要 |
| 筋力特性 | 筋肉 | 電動モーター(トルク・速度に上限) | 素早い動きがモーター性能を超える |
身長170cmの作業者が腰の高さの台から物を取る動作を130cmのロボットに写すと、台は胸の高さになり腕の角度が一変します。関節角度のコピーでも手先位置のコピーでも破綻するため、人間の動作データを利用する場合には、体格差や関節構造の違いを吸収しつつ動作の「意図」を再現する最適化計算⸺リターゲティング※が必要になるのです。
6-2. 加工の全工程 ⸺ 翻訳の前に掃除がある
| 処理 | 内容 | 放置するとどうなるか |
|---|---|---|
| キャリブレーション | 収録前に基準姿勢(Tポーズ等)で体格をセンサーに覚えさせる | 骨格推定がズレて全データが歪む |
| 座標系の統一 | ソフトごとに違う「上」の軸・左右の定義を統一 | ロボットが横倒し・鏡像で動く |
| ノイズ除去 | センサーの細かい震え(ジッタ)を平滑化 | ガタガタ震える動きを学習してしまう |
| 欠損補完 | 通信断・遮蔽で抜けたフレームを前後から補間 | 動作が瞬間移動する |
| 時刻同期 | モーキャプ・カメラ・グローブ等のタイムスタンプを統一 | 「見た物」と「した動作」がズレ、AIが因果を誤学習 |
| 関節名の統一 | 機器ごとに違う関節名を対応表で統一 | 腕と脚が入れ替わる等の変換事故 |
| 骨格・角度の変換 | 人間の骨格ツリーと回転表現(オイラー角=3角度/クォータニオン※=4値)をロボット形式へ | 関節が突然反転する(ジンバルロック等) |
| リターゲティング | 体格差を吸収し動作の意図を保って関節角度を計算する中核処理 | 手が届かない・姿勢が破綻 |
| 可動域制限・自己衝突※回避 | 関節限界内に収め、腕が胴体を突き抜けないよう修正 | 実機で関節や機体を壊す |
| 床との接触調整 | 足のめり込み・浮き・滑り(フットスケーティング)を修正 | 歩行学習が破綻する |
| 重心調整・速度/トルク制限 | 転倒しない姿勢へ微修正し、モーター性能内の動きに制限 | 即転倒・モーター過負荷 |
| 指・手の変換 | 5本指データをロボットハンドの自由度に写像 | 把持に失敗する |
| 品質チェック・メタデータ※・アノテーション※ | 目視+自動チェック、収録条件の記録、作業区間や成否のラベル付け | 不良データの混入、後から使えないデータ化 |
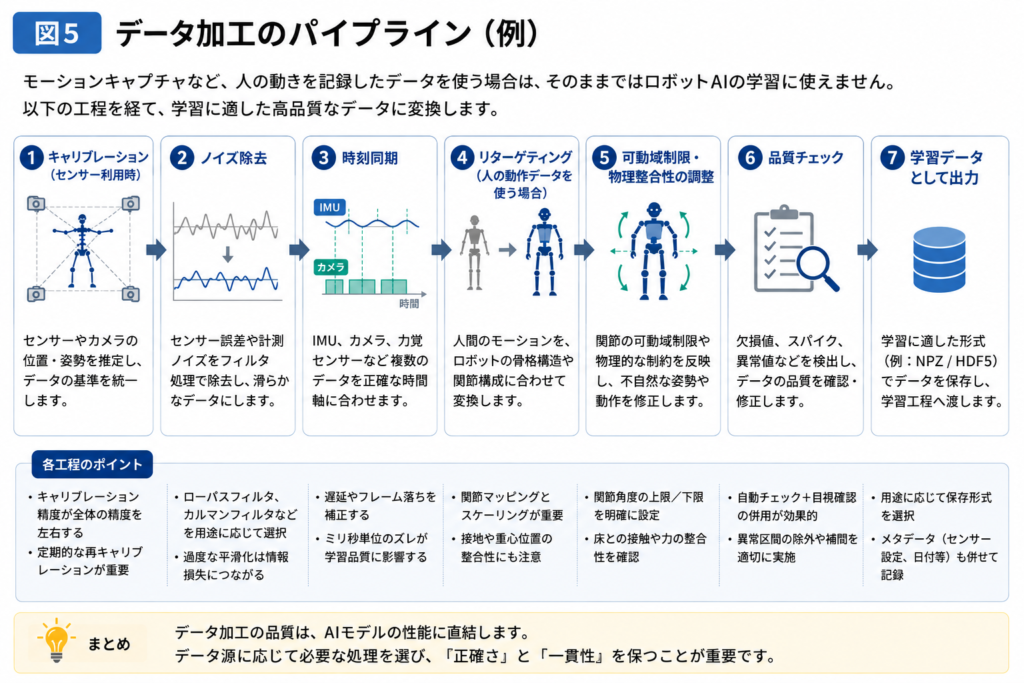
処理の考え方は多くのヒューマノイドに共通しますが、関節構成・可動域・体格(リンク長)・質量分布・アクチュエータのトルクや速度の限界・足や手の構造・制御周期など、具体的な制約値は機体ごとに異なります。G1の場合はコミュニティ製の変換ツールが公開されているほか、NVIDIAは約288時間分(14万件超)の人間モーションキャプチャをG1向けにリターゲティングしたデータセット「BONES-SEED」を公開しており、大規模なリターゲティングの実例として参考になります。
データ収集を始める前に決めておくこと
収録後に変更が効きにくい項目は、社内収録でも外部委託でも最初に確定させておくと手戻りを防げます。⸺対象ロボットの機種・関節構成/対象作業と繰り返し数/必要な関節(全身か上半身か、指の要否)/精度とサンプリング周波数※/データ量(時間・エピソード※数・被験者数)/出力フォーマット/座標系(Y-up/Z-up、右手/左手系)/タイムスタンプ形式と同期方法/アノテーションの内容と粒度/カメラ映像・力覚データの有無/使用予定のシミュレータ・学習手法/データの権利関係(所有権・二次利用)/個人情報の扱い(映像の顔・被験者同意)。
収録要件に合うモーションキャプチャーを選ぶには?
必要なデータや収録環境を整理したら、それに合う計測方式を検討します。第1弾では、ロボティクス用途におけるモーションキャプチャーの役割と、光学式・慣性式・マーカーレス式の使い分けを解説しています。
ロボティクス用途のモーションキャプチャーの選び方を読む(第1弾)
6-3. ファイル形式の早見表
加工の各段階でデータは形式を変えます。たとえばモーションデータをPyTorchで学習し、NVIDIA製GPUを積んだ実機へ実装する場合の一例を挙げると、「BVH※/FBX(収録)→CSV/NPZ/HDF5※(加工後)→PTH※(学習済みAI)→ONNX→TensorRT Engine(実機搭載)」という旅になります。あくまで代表例であり、構成によって経路は変わります。主要な形式を一覧にしておきます。
| 形式 | 何を保存するか | 主に使う工程 | 一言で言うと |
|---|---|---|---|
| BVH | 骨格構造+関節角度の時系列 | 収録・変換 | モーキャプ界の「履歴書+日記」 |
| FBX | モデル+モーション等を丸ごと | 収録・変換 | 3D業界の「全部入り宅配便」 |
| CSV | 表形式の数値(関節角度・センサー値) | 全工程 | 「カンマ区切りの表」。最も汎用的 |
| JSON | 設定・アノテーション・メタデータ | 全工程 | 「入れ子にできるラベル付きメモ」 |
| YAML | 学習条件・ROS設定 | 学習・実機 | 「人間が書きやすい設定用紙」 |
| NPZ/HDF5 | 加工済み数値データ・データセット | 加工・学習 | 数値データの「圧縮保存箱」 |
| ROS Bag/MCAP | ロボットの全センサー・指令の録画 | 実機テスト・ログ | ロボットの「ドライブレコーダー」 |
| URDF | ロボットの構造定義(ROS系標準) | モデル・シミュ・実機 | ロボットの「設計図兼身分証」 |
| MJCF | MuJoCo用のロボット・環境定義 | シミュレーション | MuJoCo方言の設計図 |
| USD | 3Dシーン全体(Isaac/Omniverse標準) | Isaacシミュ | 3D世界の「舞台セット一式」 |
| STL/OBJ | 3D形状(メッシュ=多角形の集合) | モデル・3Dプリント | 「形だけ/色付きの3Dデータ」 |
| PLY/PCD | 点群※(LiDAR等の3D点の集合) | 3D計測・認識 | 「空間を点の粒で写した写真」 |
| PTH/PT | 学習済みAIの重み(PyTorch) | 学習 | AIの「脳のセーブデータ」 |
| ONNX | AIモデルの共通交換形式 | デプロイ※ | AIモデルの「PDF」 |
| TensorRT Engine | 特定GPU向けに最適化した実行専用AI | 実機 | 「その機体専用にチューンした脳」 |
| MP4/PNG | 映像・静止画 | 収録・VLA学習 | 普通の動画・写真 |
なおG1のロボットモデルは、URDF※・MJCFがUnitree公式GitHubで、Isaac用のUSDアセットがNVIDIA側で提供されており、形式変換の手間が少ないのも題材向きの理由の一つです。また、NVIDIAが公開するG1向けの参照ワークフローでも、テレオペで収集したデータをシミュレーションではHDF5、実機ではMCAPで記録し、LeRobot形式に変換してGR00Tを追加学習する流れが採られており、この表の形式がそのまま現場で使われています。
この章の主な参考資料:Unitree G1公式ページ・公式GitHub(https://www.unitree.com/g1 / https://github.com/unitreerobotics)/Movella(Xsens)技術資料(https://www.movella.com/)
ロボットの「手」では、身体差がどう問題になるのか?
手指では、関節構成の違いに加えて、物体との接触や力加減も課題になります。第2弾では、手に特有の身体差ギャップと、リターゲティング・学習による補正・触覚情報の役割を詳しく解説しています。
ロボットハンドの身体差ギャップと、手の動作を学ばせる方法を読む(第2弾)
第7章 AIはどうやって動きを覚えるのか ⸺ 学習方法・データ・モデルの違い
7-1. ロボットの中の「AI」は1つではない
1体のヒューマノイドの中では、役割の異なる複数のAIが分担して働きます。カメラ映像から物を認識するVision、地図と経路を扱うNavigation、「片付けて」を手順に分解するタスクプランナ(LLM系)、音声を聞き取るSpeech⸺そして本章の主役である、動作そのものを出すPolicy(方策※)です。歩行・バランスを担うLocomotion、腕と手の作業を担うManipulation、映像と言語から行動まで一体で出すVLA※が、Policyの代表格です。
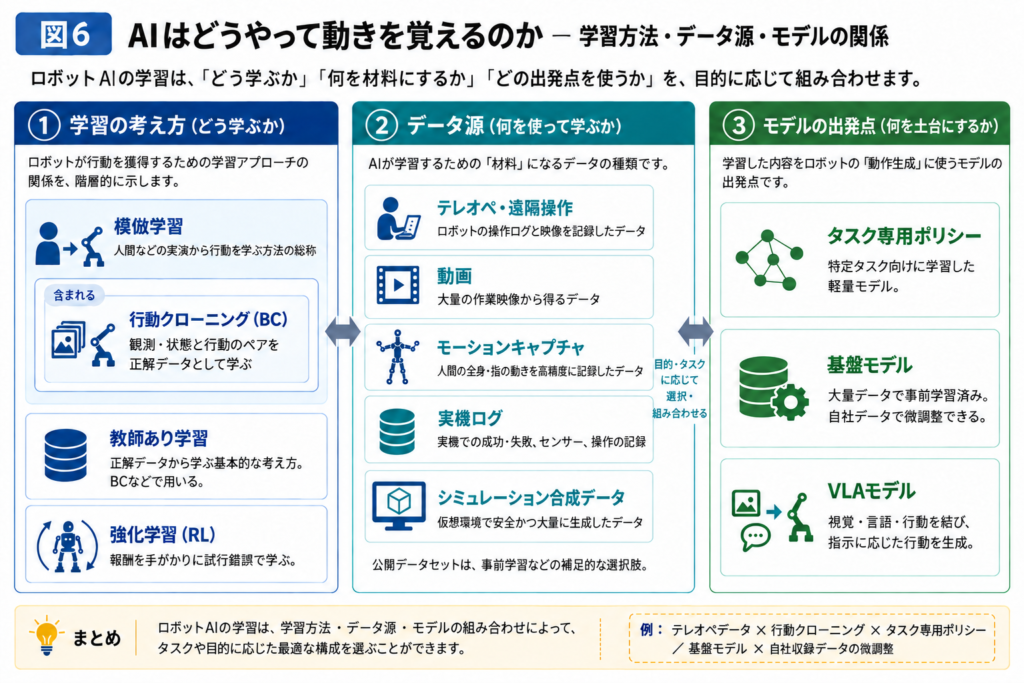
「AIに動きを学ばせる」という話には、実は3つの別の問いが混ざっています。どう学習させるか(アルゴリズム)、学習データをどこから得るか(データ源)、どのモデルを使うか(出発点)。順に見ていきます。
7-2. どう学習させるか ⸺ 主な学習の考え方(教師あり学習・模倣学習・行動クローニング・強化学
習)
| 手法 | 必要なもの | 向いている動作 | 長所 | 短所 | たとえ |
|---|---|---|---|---|---|
| 教師あり学習※ | 入力と正解のペア | (大分類。行動クローニングなど「正解データから学 ぶ」手法の土台) | 理論が確立 | 正解データが必要 | 「問題集と解答で勉強」 |
| 模倣学習※ | 人間のお手本動作 | 人間が実演できる作業全般 | 報酬設計不要で直感的 | お手本にない状況に弱い | 「師匠の背中を見て覚える」 |
| 行動クローニング※ | 状態と行動のペア | 短めの定型作業 | 実装が簡単(模倣学習の最も単純な形) | 誤差が蓄積して脱線しやすい | 「お手本ビデオの丸暗記」 |
| 強化学習 | 報酬関数※+大量の 試行環境 | 歩行・バランス等 | お手本を超えられる、頑健 | 報酬設計が職人技 | 「ゲームを何万回もやり込む」 |
上の4行は並列の分類ではありません。模倣学習は、人間などの専門家の実演から行動を学ぶ手法の総称で、その最も基本的な方法が行動クローニング⸺観測・状態と行動のペアを正解データとして教師あり学習する方法⸺です(模倣学習には、逆強化学習や敵対的模倣学習など、単純な教師あり学習では括れない系統もあります)。一方の強化学習は、正解の行動ではなく報酬を手掛かりに試行錯誤から学ぶ別の枠組みです。実務では、模倣学習で土台を作り強化学習で仕上げる、といった組み合わせがよく使われます(7-5参照)。
7-3. 学習データをどこから得るか ⸺ 5つの経路
| 経路 | 得られるもの | 長所 | 短所 |
|---|---|---|---|
| テレオペレーション | ロボットの体で記録した操作ログ+映像 | 人間骨格からロボット骨格への後処理リターゲティングが原則不要(操作中のIKや座標変換は行われる)。力加減も入る。作業学習で広く使われる | 収集が人力で遅い |
| 動画 | 大量の作業映像 | 安く大量に集まる。事前知識の獲得に | 関節角度も力も映って いない |
| モーションキャプチャ | 高精度な全身・指の3Dデータ | 関節情報が正確、現場収録可 | リターゲティング必須 (第6章) |
| 実機ログ | 実機の成功/失敗の記録 | 現実そのもの。仕上げ・現場適応に | 収集が遅く高価・破損 リスク |
| 合成データ | シミュレータが自動生成したデータ | 安全・高速・大量(NVIDIAはGR00T N1発表時、少量の実演から約78万本の動作軌道を11時間で生成したと公表) | 現実とのギャップが残 る |
このほか、他機関が公開するデータセット(Open X-Embodiment※等)を事前学習に使う選択肢もあります(前編・第3章)。
7-4. どのモデルを使うか ⸺ 3つの出発点
| 出発点 | 内容 | 向き | 留意点 |
|---|---|---|---|
| タスク専用ポリシー | 特定の動作(歩行、特定の組立作業など)専用に、ゼロから学習した比較的小さなAI | 単一タスクを確実に。実機での実行も軽い | タスクごとに作り直しが必要 |
| VLAモデル | 映像+言語→行動を一体で出す大型AI | 「コップを取って」のような言語指示・多目的作業 | モデルが大きく実機推論が重い |
| 基盤モデル | 大量データで事前訓練済みの汎用AI(NVIDIA Isaac GR00T⸺N1.7から商用ライセンス付与⸺、Physical Intelligenceのπ0系、Google DeepMindのGemini Roboticsなど)。少量の自社データでファインチューニング※して使う | 開発期間の大幅短縮 | ブラックボックス性、ライセンス確認が必要(研究用途限定のモデルもあり、商用利用の可否は要確認) |
7-5. 組み合わせの実際
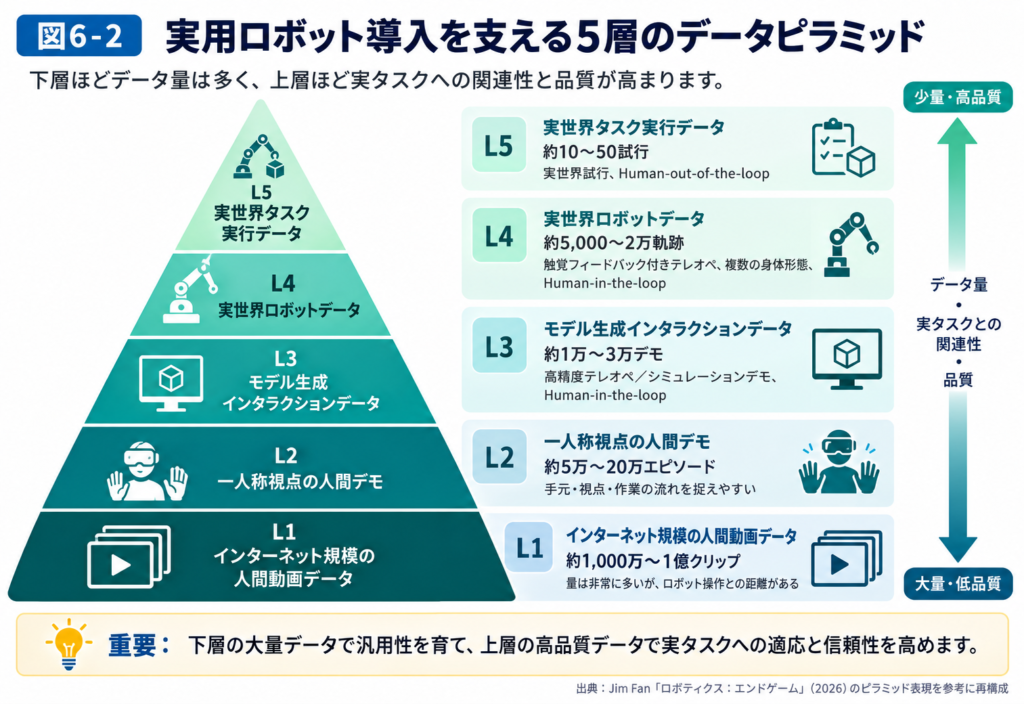
3つの軸は自由に組み合わされます。目安としては、歩行・バランスは「強化学習×シミュレーション試行」(G1の公開事例多数。AI学習によらない古典制御⸺MPC※やZMP歩行※⸺という選択肢もあります)、特定の作業タスクは「行動クローニング×テレオペデータ」、熟練技能や人間らしい動作の転写は「模倣学習×モーションキャプチャ(+強化学習で仕上げ)」、多目的・言語指示型は「基盤モデル×自社収録データの微調整」。さらに、実演データを「種」に強化学習で仕上げる、下半身は強化学習で上半身はテレオペで作る、実演データを報酬に混ぜ込む(研究分野ではAMP等と呼ばれる系統)⸺といった併用も広く行われています。
この章の主な参考資料:NVIDIA Isaac GR00T N1発表資料(78万軌道・11時間の記載を含む:https://nvidianews.nvidia.com/news/nvidia-isaac-gr00t-n1-open-humanoidrobot-foundation-model-simulation-frameworks)/NVIDIA Isaac GR00T開発者ページ(https://developer.nvidia.com/isaac/gr00t)/NVIDIA Isaac GR00T N1.7 早期アクセス告知(https://forums.developer.nvidia.com/t/early-access-isaac-gr00t-n1-7-open-reasoning-vla-model-for-humanoid-robotics/366916)/LeRobot公式ドキュメント(https://huggingface.co/docs/lerobot/en/unitree_g1)
第8章 シミュレーションだけでは動かない理由 ⸺ Sim2Realと実機実装
8-1. 学習と検証の場
強化学習や歩行・バランス制御では、シミュレータ内で数百~数千体の仮想ロボットを並列に走らせ、大量の試行を行う方法が広く使われます。一方、模倣学習やVLAの微調整では、事前に収録した実機・テレオペ・映像データを使って学習する(オフライン学習)場合もあります。いずれの場合も、実機に載せる前の検証の場としてシミュレーションは重要です。ロボットモデルを読み込み、摩擦や重力などの物理パラメータと床・物体・仮想センサーを設定し、衝突・転倒・成功率を確認し、実機の制御周期(毎秒数百回)と整合させます。
検証を通ったAIは、必要に応じて量子化(数値精度を落として軽くする)・蒸留(大きなAIの能力を小さなAIに写す)※・TensorRT等による最適化を行ったうえでロボット内蔵コンピュータに載り、ROS 2やSDK経由でモーターとつながります。実機テストは吊り下げ→低出力→本番と段階的に進め、全センサーと指令をログ(ROS Bag/MCAP※)に録画し、失敗データを再学習に回します。
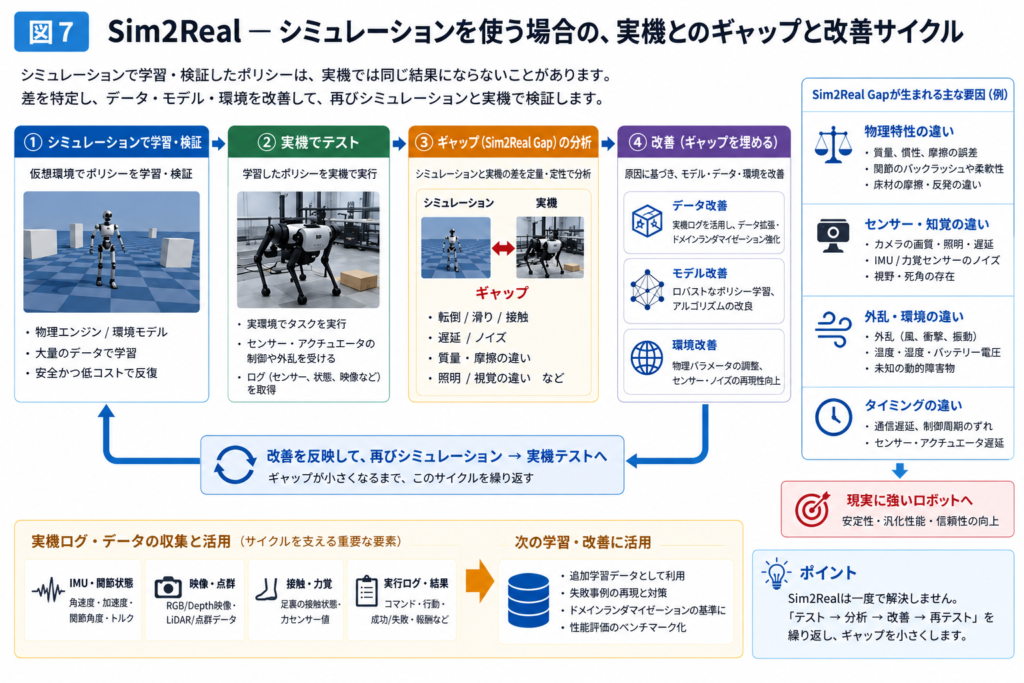
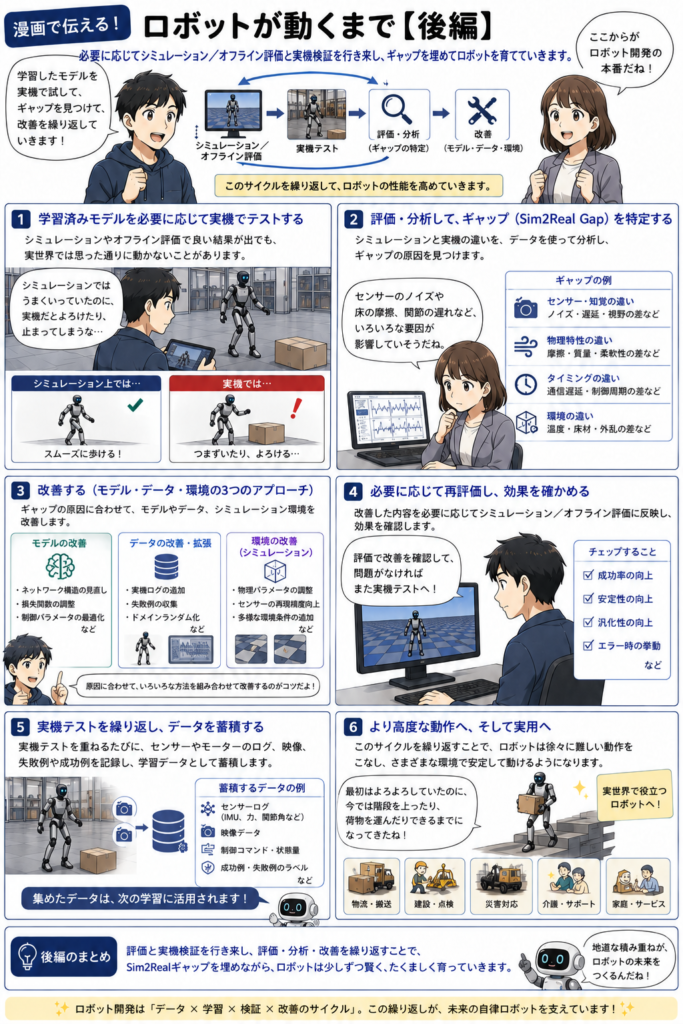
シミュレーションを学習や検証に使う場合、そこで立ちはだかるのがSim2Real※ギャップ⸺シミュレーション(Sim)と現実(Real)のズレです。
8-2. なぜ実機では転ぶのか ⸺ 10の原因
| 原因 | 何が起きるか | 主な対策 |
|---|---|---|
| 摩擦の違い | 仮想の床はツルツル、実際はカーペット。足が滑る・引っかかる | Domain Randomization※で摩擦を幅広く学習 |
| モーター性能の違い | 仮想は理想モーター、実機は応答遅れ・発熱がある | モーターの応答モデルを仮想側に組み込む |
| センサー誤差 | 実機のIMUやカメラにはノイズ・ドリフトがある | 仮想側に人工ノイズを注入して学習 |
| 通信遅延 | 指令が数ms~数十ms遅れ、バランス制御が破綻 | 遅延を仮想側に再現、実機はオンボード実行に |
| 床面の違い | 傾き・段差・柔らかさが想定外 | 多様な地形で訓練 |
| 重心のずれ | モデルの質量分布と実機(配線・バッテリー位置)が違う | 実機同定(実測してモデル修正) |
| バッテリー状態 | 電圧低下でトルクが落ち、朝は動いたのに夕方転ぶ | 電圧変動もランダム化、運用ルール化 |
| モデルの計算速度 | 大きいAIが制御周期に間に合わずカクつく | TensorRT化・モデル縮小 |
| 安全制限 | 実機側のリミッタで学習した動きが再現されない | 学習時から実機と同じ制限をかける |
| 実機の個体差 | 同じ機種でも1台ごとに癖がある | 個体キャリブレーション、頑健化学習 |
8-3. ギャップを埋める実務の定石
- システム同定※:実機の質量・摩擦・モーター応答を実測し、シミュレータのパラメータを実機に寄せる
- Domain Randomization:残る差は、摩擦・質量・遅延・照明を毎回ランダムに変えた学習で「幅」として吸収する(代表的な対策の一つ)
- オンボード化・軽量化:外部ネットワーク由来の遅延を大幅に減らすため、AIをロボット内蔵コンピュータで直接動かす(内部通信や演算の遅延は残る)
- 段階的実機テスト+再学習:吊り下げ→低出力→本番の順で試し、実機ログを学習に還流する
この章の主な参考資料:NVIDIA Isaac Sim/Lab公式ドキュメント(https://developer.nvidia.com/isaac/sim)/MuJoCo公式(https://mujoco.org/)/MCAP公式(https://mcap.dev/)
Sim-to-Realギャップを、実世界データの視点から掘り下げる
シミュレーション側の対策に加え、どのような実世界データを組み合わせるかも重要です。第3弾では、ギャップの原因と対策の限界、人間の動作データとロボット側のデータの補完関係を、研究事例とともに解説しています。
Sim-to-Realギャップと、実世界データを組み合わせる意味を読む(第3弾)
第9章 代表的な3つの構成例
道具とデータの組み合わせ方には、よく見られる型があります。あくまで例であり、実際の構成は目的・予算・チームによって大きく異なります。
構成例A:NVIDIA中心型(二層構造) ⸺ 役割の違う2つの学習を重ねる構成です。①低レベルの全身制御:モーションキャプチャ→リターゲティング→Isaac Sim/Isaac Labで強化学習し、「バランスを保ちながら指示どおりに全身を動かす」コントローラを作る(NVIDIAのSONICのような全身制御モデルや、AGILEのような全身制御ポリシーを学習するフレームワークがこの層を担う)。②高レベルの行動:G1をテレオペして収集した映像・操作データでGR00T N1.7を微調整し、「これを取って」に応じた動作指令を出すVLAを作る。実行時は、GR00T N1.7がSONIC用の動作表現(latent motion token)を出し、SONICがそれを全身の動作へ変換して実機を制御します。実機への展開にはROS 2/SDKや、必要に応じてONNX・TensorRT等の実行基盤が使われます。NVIDIAが2026年に公開したG1向けの公式ワークフローがこの形で、Isaac Labでの強化学習とGR00Tの微調整は、同じ「学習」でも担当する層が異なる点に注意してください。
構成例B:MuJoCo中心型 ⸺ モーションデータ(自前収録/公開データセット)→Python→MuJoCo→強化学習・模倣学習→ROS 2+SDK→実機。
構成例C:テレオペ中心型(LeRobot型) ⸺ VR機器等で遠隔操作→映像・操作ログ・関節状態を同時収録→LeRobot形式でデータセット化→行動クローニング/VLA微調整→実機再生→失敗収集→追加学習。
| 項目 | A:NVIDIA中心型 | B:MuJoCo中心型 | C:テレオペ中心型 |
|---|---|---|---|
| よく使われる場面 | 全身制御+言語指示型VLAの統合、合成データの大量生成 | 歩行・全身制御の研究、アルゴリズム開発 | 把持・両手作業などタスク特化の学習 |
| 長所 | エコシステム統合、基盤モデル直結、G1向けの公式ワークフローあり | 無料・軽量・物理が正確 | 後処理リターゲティングが原則不要、現実データで確実 |
| 短所 | 高性能GPU必須、習得が重い | 映像のリアルさ不足 | データ収集が人力で遅い |
| 費用・難易度 | 相対的に高い(GPU投資・習熟が必要) | 相対的に低コストで開始可能 | 中間(実機+操作デバイス+収録の人手) |
複数の構成例を組み合わせること(例:テレオペで実データを収集し、シミュレーションの合成データで増幅し、基盤モデルを微調整する)も広く行われています。
この章の主な参考資料:NVIDIA Isaac公式(https://developer.nvidia.com/isaac)/GR00T-WholeBodyControl(https://github.com/NVlabs/GR00T-WholeBodyControl)/NVIDIA「Isaac GR00TとUnitree G1によるEnd-to-End開発」コース(https://docs.nvidia.com/learning/physical-ai/gr00t-e2e-workflow/latest/index.html)/LeRobot公式(https://huggingface.co/docs/lerobot)
第10章 誰がつくるのか ⸺ 人材・安全・役割分担
| 役割\工程(●主担当 ○関与) | 計画 | データ収集 | データ処理 | 学習 | シミュ | 実機 | 運用改善 |
|---|---|---|---|---|---|---|---|
| ロボットエンジニア(システム統合) | ○ | ○ | ○ | ● | ● | ||
| 機械設計者(ハンド改造・治具) | ○ | ○ | ○ | ||||
| 制御エンジニア(モーター・バランス制御) | ○ | ○ | ○ | ● | ○ | ||
| ROSエンジニア(通信・ログ基盤) | ○ | ○ | ○ | ● | ○ | ||
| AI/MLエンジニア(学習・評価) | ○ | ○ | ● | ○ | ○ | ● | |
| シミュレーションエンジニア(環境構築・合成データ) | ○ | ○ | ○ | ● | ○ | ||
| モーションキャプチャ技術者(機材運用・収録品質) | ○ | ● | ○ | ○ | |||
| データエンジニア(変換パイプライン) | ○ | ○ | ● | ○ | ○ | ||
| アノテーター(ラベル付け・目視チェック) | ○ | ● | ○ | ||||
| 安全管理担当(安全手順・非常停止運用) | ○ | ○ | ● | ○ | |||
| PM(工程・予算・調整) | ● | ○ | ○ | ○ | ○ | ○ | ● |
フルセットで11役割ですが、既存ロボットを活用する開発なら機械設計はほぼ不要になり、少人数チームでは複数役割の兼務が一般的です。一例として「①ロボット/制御担当(+ROS+安全)」「②AI担当(+シミュレーション)」「③データ担当(モーキャプ+データエンジニア+アノテーション)」「④PM」といった分担が考えられます。なお安全管理は兼務であっても省略できない役割です。実機テストの現場では、非常停止と吊り下げの運用手順を決める担当を必ず置きます。
終章 複数の入口を持つ、一枚の全体フロー
最後に、後編全体の結論として、開発の流れを一枚に描き直します。前編から繰り返してきた通り、入口はひとつではありません。どの入口から入るか(そして複数をどう組み合わせるか)は、目的とタスクが決めます。
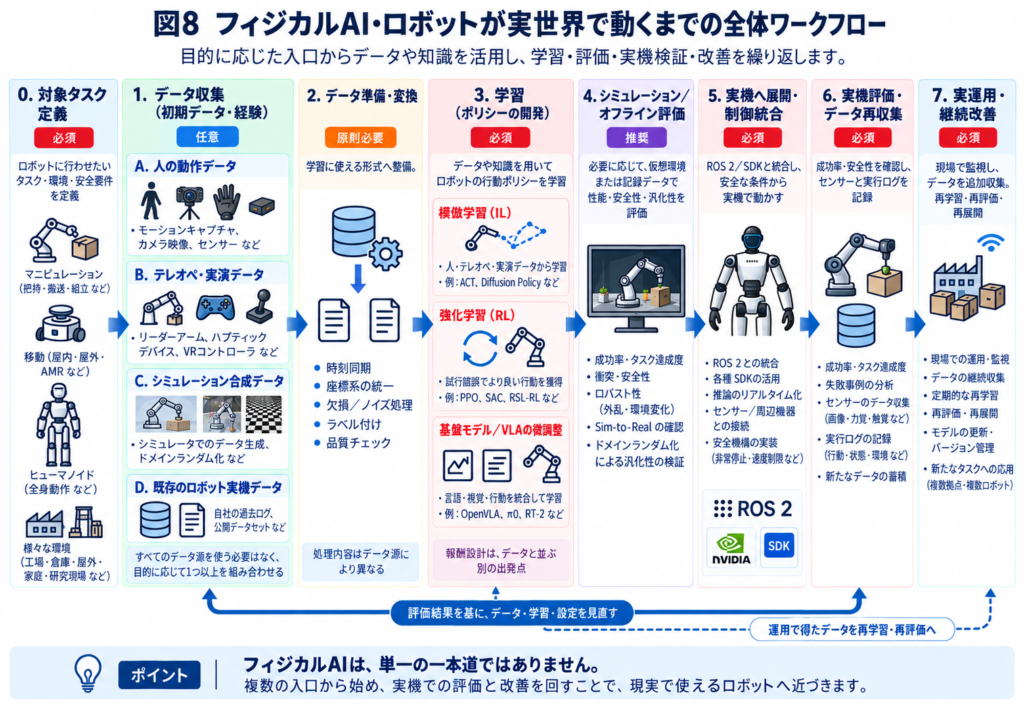
冒頭の問いに戻りましょう。「ロボットがAIで動く」とは、この図を何周も回すことでした。目的に合った入口からデータを集め、掃除し、必要なら翻訳し、学習させ、仮想と現実のズレに向き合い、失敗をまた教材にする。フィジカルAIの進化とは、突き詰めればこのループの回転速度の進化です。
後編の用語集(29語)
| # | 用語 | 説明 |
|---|---|---|
| 1 | BVH/FBX | モーションキャプチャの標準保存形式/3Dモデルとモーションの複合形式。 |
| 2 | URDF/MJCF/USD | ロボットの構造を定義する3つの「設計図」形式(ROS系/MuJoCo用/Isaac用)。 |
| 3 | ROS Bag/MCAP | ロボットのセンサー・指令を丸ごと録画するログ形式。「ドライブレコーダー」。 |
| 4 | HDF5/NPZ | 大規模な数値データの保存形式。 |
| 5 | PTH/PT | PyTorchの学習済みAI重みファイル。「脳のセーブデータ」。 |
| 6 | 点群 | LiDAR等が出力する、空間を3D点の集合で表したデータ。 |
| 7 | キャリブレーション | 計測前にセンサーへ基準(体格・姿勢)を覚えさせる調整作業。 |
| 8 | サンプリング周波数 | 1秒間に何回データを記録するか(例:120Hz=毎秒120回)。 |
| 9 | 時刻同期 | 複数の機器の時計・記録タイミングを合わせること。 |
| 10 | リターゲティング | 人間の動きを、体格・関節数の違うロボット用に変換する処理。 |
| 11 | 可動域 | 関節が動かせる角度の範囲。ロボットには機械的な限界がある。 |
| 12 | 自己衝突 | ロボットの腕などが自分の体にぶつかること。 |
| 13 | オイラー角/クォータニオン | 3D回転の表現方法(3つの角度/4つの数)。 |
| 14 | アノテーション | データに「把持動作」「成功/失敗」等のラベルを付ける作業。 |
| 15 | メタデータ | データについてのデータ(収録日・被験者・機材設定など)。 |
| 16 | 教師あり学習 | 入力と正解のペアから学ぶ機械学習の大分類。 |
| 17 | 行動クローニング | 模倣学習の最も基本的な方法。観測と行動のペアを正解データとして教師あり学習する。 |
| 18 | 報酬関数 | 強化学習で「何が良い行動か」を点数で定義するルール。 |
| 19 | 方策(ポリシー) | 「センサー入力→行動」を決めるAIの頭脳部分。学習の成果物。 |
| 20 | VLAモデル | Vision-Language-Action。映像と言語を理解し行動を出力するAI。 |
| 21 | 基盤モデル | 大量データで事前訓練済みの汎用AI。少量データの微調整で使える(商用利用の可否はモデルごとのライセンスで異なる)。 |
| 22 | ファインチューニング | 基盤モデルを自社タスク向けに少量データで追加訓練すること。 |
| 23 | 合成データ | シミュレータ等が自動生成した学習データ。実データを増幅できる。 |
| 24 | エピソード | 1回のタスク実行の始めから終わりまでの記録単位。 |
| 25 | MPC/ZMP歩行 | AI学習によらない古典制御の代表(予測計算型制御/足裏の力の中心点管理による歩行)。 |
| 26 | Domain Randomization | 摩擦・照明等をわざとランダムに変えて学習し、頑健なAIにする技術。 |
| 27 | Sim2Real | シミュレーションで学んだ能力を実機に移すこと。その差が「ギャップ」。 |
| 28 | システム同定/量子化・蒸留 | 実機の物理特性を実測しシミュレーションを合わせる作業/AIを軽くする2大技術。 |
| 29 | Open X-Embodiment | 世界の研究機関が持ち寄った共同ロボットデータセット。 |
※本記事の企業・製品情報は2026年9月時点の公開情報に基づきます。仕様・価格・提供状況は変動するため、最新情報は各公式サイトをご確認ください。